2026-11-11
当生成式AI的门槛降至“一键”,内容创作的底层逻辑正在被重塑。北大汇丰“不止MBA”系列讲座现场,北京大学信息工程学院院长助理、长聘副教授、视觉信息智能学习实验室(VILLA)负责人张健教授,为现场听众带来了一场关于AIGC内容生成与版权保护的深度分享。
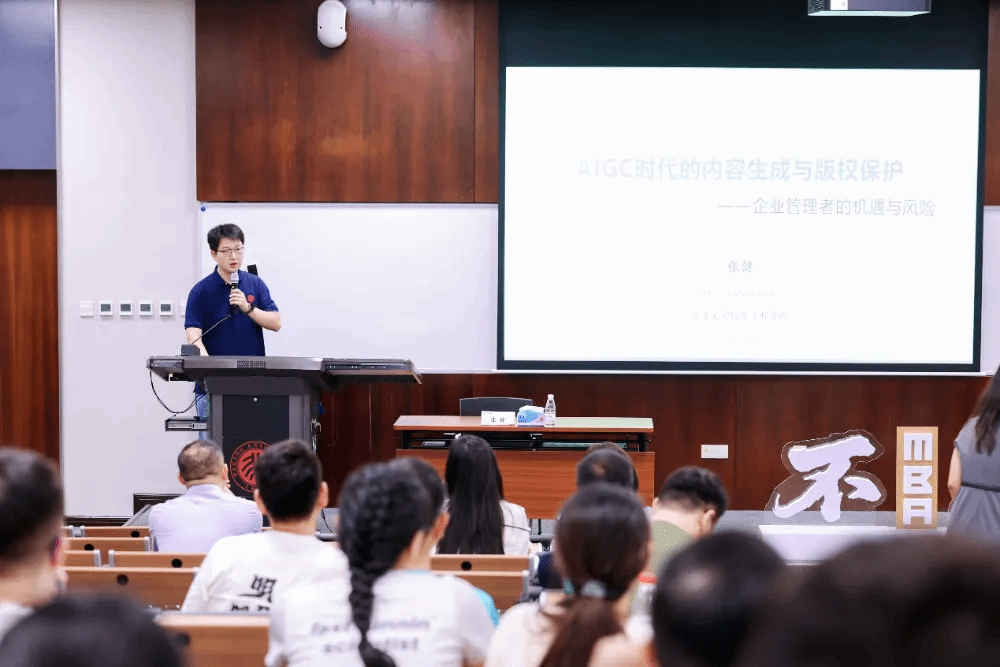
用一张图换一张脸,用一句话生成一段视频——生成这件事,已经不再需要专业技能。张健教授开场即指出,当前AIGC的核心变化不是"能生成",而是"可控地生成":从最初输入数据、输出不可控结果,到今天一句提示词就能精准对齐意图,技术的演进让内容生产变得前所未有地自由,也让伪造与篡改变得足以以假乱真。"现在的内容,不注意已经是假的了,不是一眼假的状态。"
“以前P图要找专业的人,现在一键即可。”传统的版权边界正在失效,企业内容资产亟待建立新的“可信防线”。
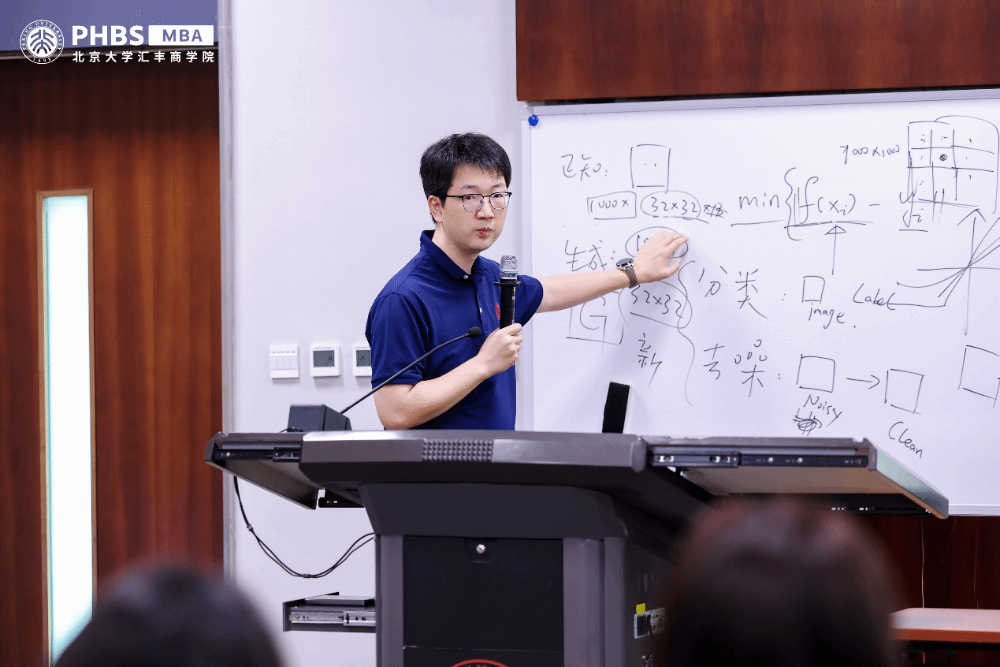
讲座中,张健教授回溯了生成技术的演进。早期的AI生成不可控,而“可控生成”一旦普及,便催生了海量天马行空的应用,也带来了连锁的安全反应。
当前生图已与语言模态精准对齐,稍不留意便足以以假乱真。这不仅局限于生图:无论是人脸、蛋白质结构,还是企业独有的小样本数据,“都可以用这个思路”。但当生成器越来越强,掌握在大众手里,传统依赖专业门槛的版权护城河便瞬间干涸。
面对风险,张健教授给出三条技术路径,并逐一拆解其边界:
被动检测。团队提出FakeShield,不只判真伪,更定位“哪里假、为何假”(光影或物理规律违背)。但鉴伪与生成是螺旋博弈,模型更新,检测器就需重训。
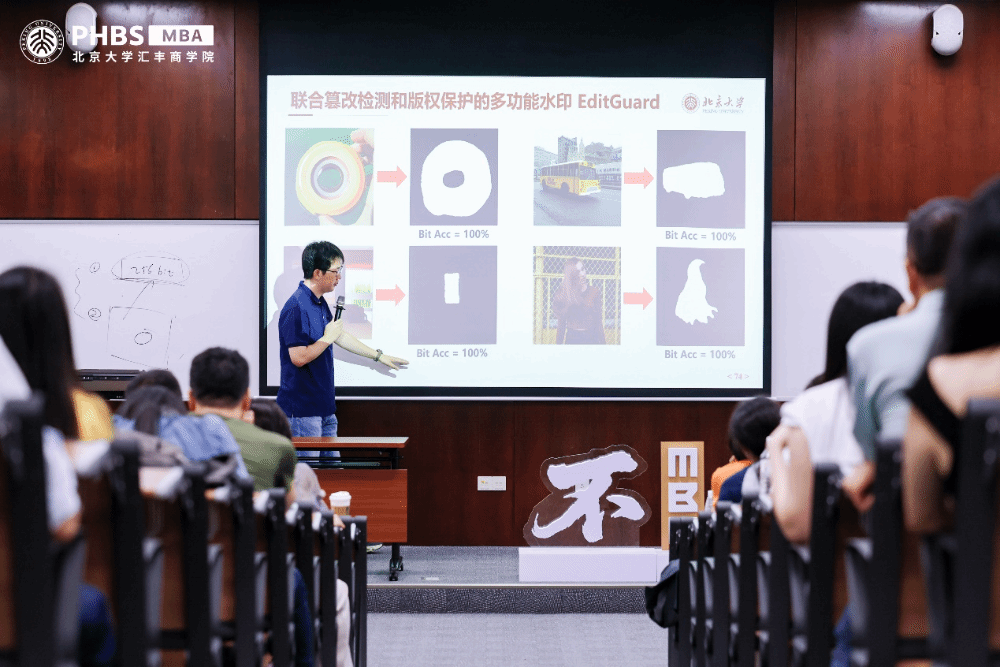
主动水印。可见水印易被抹,不可见水印求保真与抗干扰。团队首创“双水印”:一维水印负责版权确权(鲁棒),二维水印负责篡改定位(脆弱)。Meta等大厂随后跟进。
内容凭证。记录从拍摄到编辑全过程,类似履历,但依赖联盟共识,且“截图、拍照”易绕开。
最棘手的,是确权与篡改的内在矛盾。张教授举例:图上被人为加了一把“凶器”,版权水印仍能解出,图确是你的,但内容已被污染。“到法院上应该说不清楚——你认不认这张图是你的?” 确权算法只能证明归属,却无法保证内容未被篡改,这是技术无法回避的张力。
技术之外,落点回归企业管理。内容确权在法庭上的胜负手,往往不是水印本身,而是过程留痕:提示词、调试次数、时间与资源投入。“法官看的是你投了多少时间、中间消耗了多少。”
企业出品任何内容,应有流程记录——谁做的、怎么调出的,将来一旦冲突,这就是证据。对学生、员工考核同理:只看结果,大模型人人满分,真正该考的是与大模型沟通、一步步推导的过程。
版权水印一旦公开易被破解,“跟魔术一样”。企业应用定制化、不公开方式保护,同时表明“我的内容有水印、可被追溯”,增加对方滥用成本。
“内容越来越便宜,模型越来越便宜,但可信越来越贵。”AIGC能力必须用,但要用得可控、留痕、可证。
作为“不止MBA”系列,本场延续“不止于身份标签,不止于知识边界,不止于当下视野”理念。从生成原理到双水印确权,张健教授为听众打开AIGC可信技术与企业治理的窗口。当生成能力普及,唯建立可信核验与留痕机制,方能平衡创新与风险。


